把 AI 从“贵重咨询”,变成“免费的 if 语句”
把 AI 从“贵重咨询”,变成“免费的 if 语句”
2026 年 9 月 15 日,一家叫 TypeSafe AI 的旧金山公司结束了约 2 年的 stealth,发布了一个叫 Jev 的模型,同步宣布 4000 万美元 seed 轮。创始人 Diogo Almeida 是前 OpenAI 的 RLHF/InstructGPT 成员。
Jev 干了一件很反直觉的事:它不生成文字。
不聊天、不写文章、不画画。它只做一件事——做判断:三选一打分、yes/no 概率,一次请求可以并行问几十个问题,70–500 毫秒返回,单次判断约 1/25 美分。
官方话术叫它“a smart if statement”——一个聪明的 if 语句。
模型的名字致敬了经济学家杰文斯和“杰文斯悖论”:资源变便宜,用量反而暴涨。这正是 TypeSafe 的增长赌注——一旦“做判断”近乎免费,软件会在后台做数百万次人类永远不会在聊天框里做的决策。
发布前,开发者被什么折磨着
三个痛点,全是“杀鸡用牛刀”。
第一,拿着大炮打蚊子。
生产软件真正需要的往往不是“写一段话”,而是“做一个判断”:工单分流、消息打标、搜索重排、agent 每一步的动作审核。被迫用大模型干这些,又慢又贵,还得写 prompt 工程去“哄”出合法 JSON,结构化输出还会漂移。
第二,模型太“会来事”。
Almeida 在采访里有句原话我印象很深:“We've been optimizing for humans and we're super human at pleasing humans.”——我们一直在为取悦人类优化,RLHF 训练出的模型擅长“显得正确”,而不是“给出可信的概率”。
但软件要的是后者:低于阈值转人工,高于阈值自动执行。一个永远 95% 自信的模型,在生产线上是危险品。
第三,agent 时代的“判断层”缺位。
agent 每做一个 tool call,其实都想先问一句“这步安全吗?该用哪个模型?”但 Claude 级别的价格让开发者“不敢问”——有安全研究者的原话是:“We don't need to know that badly.”(也没想知道到那个地步。)
Jev 把单次判断打到 1/25 美分,“每个动作都先审判一次”在经济上终于成立了。
它是怎么火起来的
HN 首发帖当天登顶,约 1800 分、480 多条评论;创始人官宣帖 6.3 万点赞、首周 400 万浏览;Vercel 把它接进 AI Gateway,称它是“Gateway 历史上采用最快的模型”;一周之内,awesome-jev 目录收录了 900 多个项目,还引发了一波开源复刻潮。
但有两句冷静的话我也得写上:
官方宣传的“快 193.6 倍、便宜 444.6 倍”是自测峰值,独立实测多在 18–25 倍量级;“零幻觉”指的只是输出格式永远合规——模型依然可能自信地选错。
神话和限定条件,我都要给你。
出圈担当:一面“审判墙”
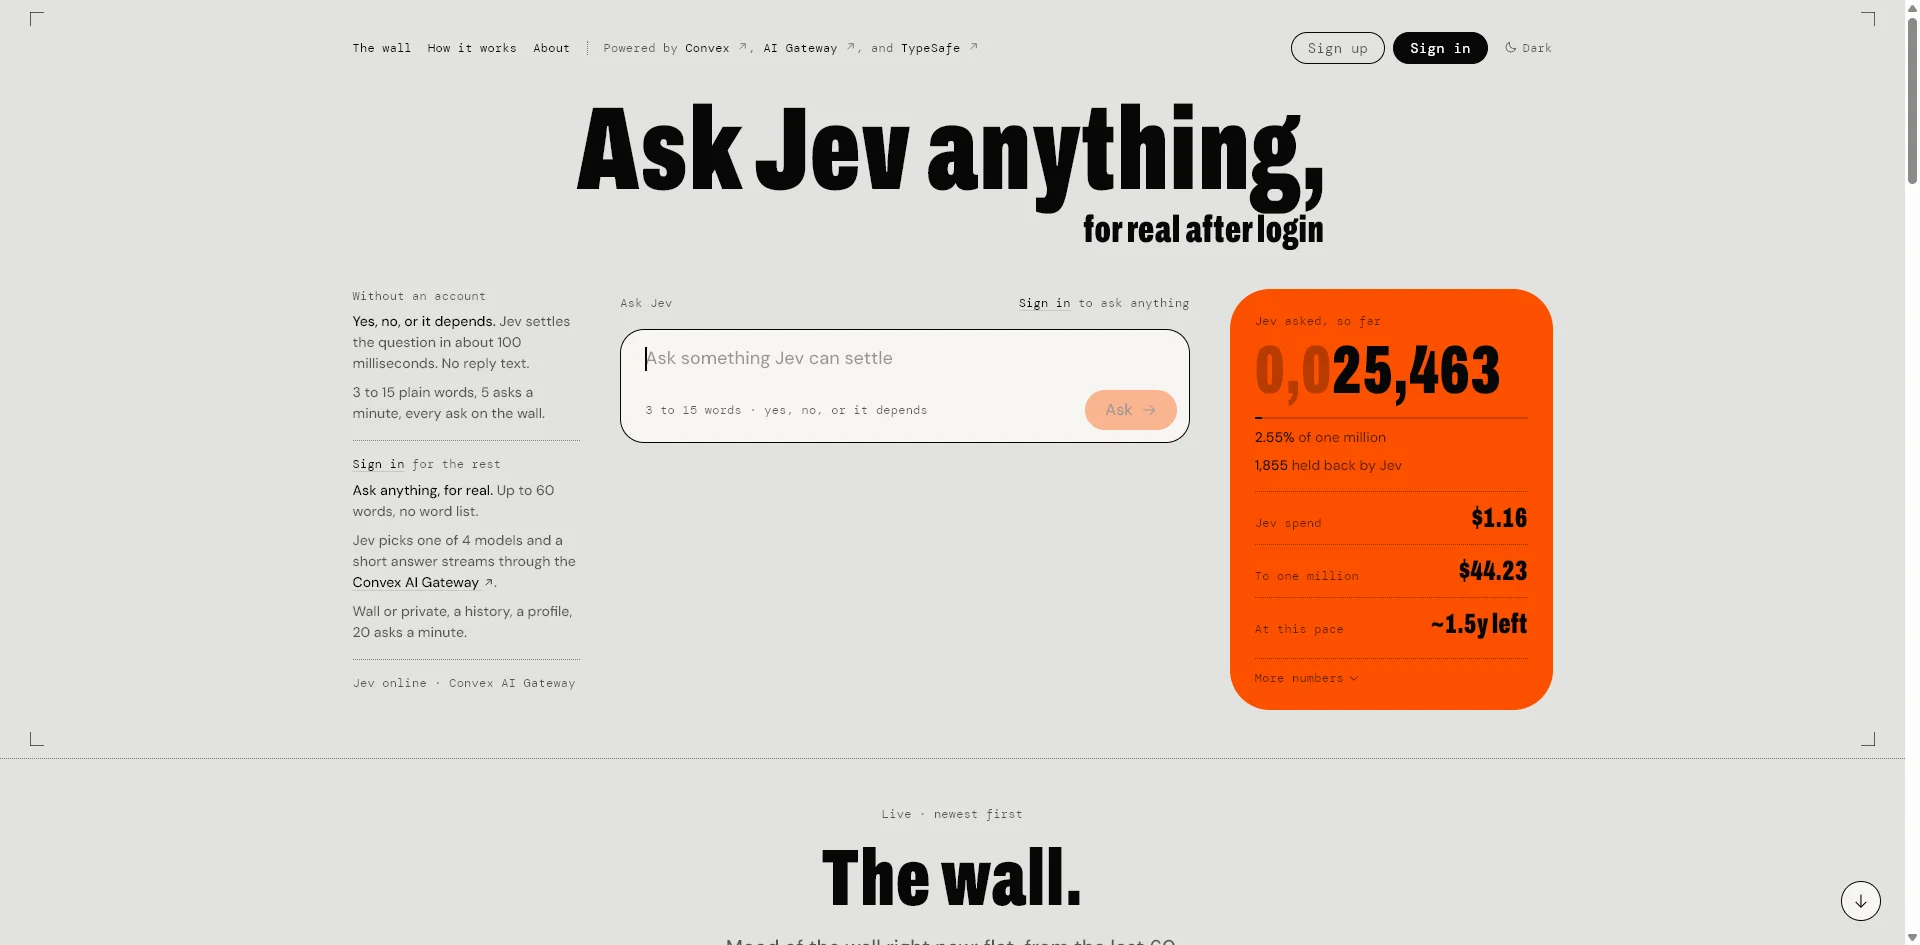
AskJev是整个专题里唯一有真实用户量级数据的项目,概念也最“出圈”。
问它一个 3–15 个词的问题,它在约 100 毫秒内给出 yes / no / 看情况的裁决,所有提问实时上墙。站长左安还去截了张图:累计 25,463 次提问,总花费——$1.16。
你没看错,两万五千次 AI 调用,一共花了一块一毛六。
以及它那个“冲向一百万次提问”的里程碑计数器,本身就是传播学:把“便宜”变成了一场全民围观的游戏。
开发者口碑担当:让 Jev 和大模型“飙车”
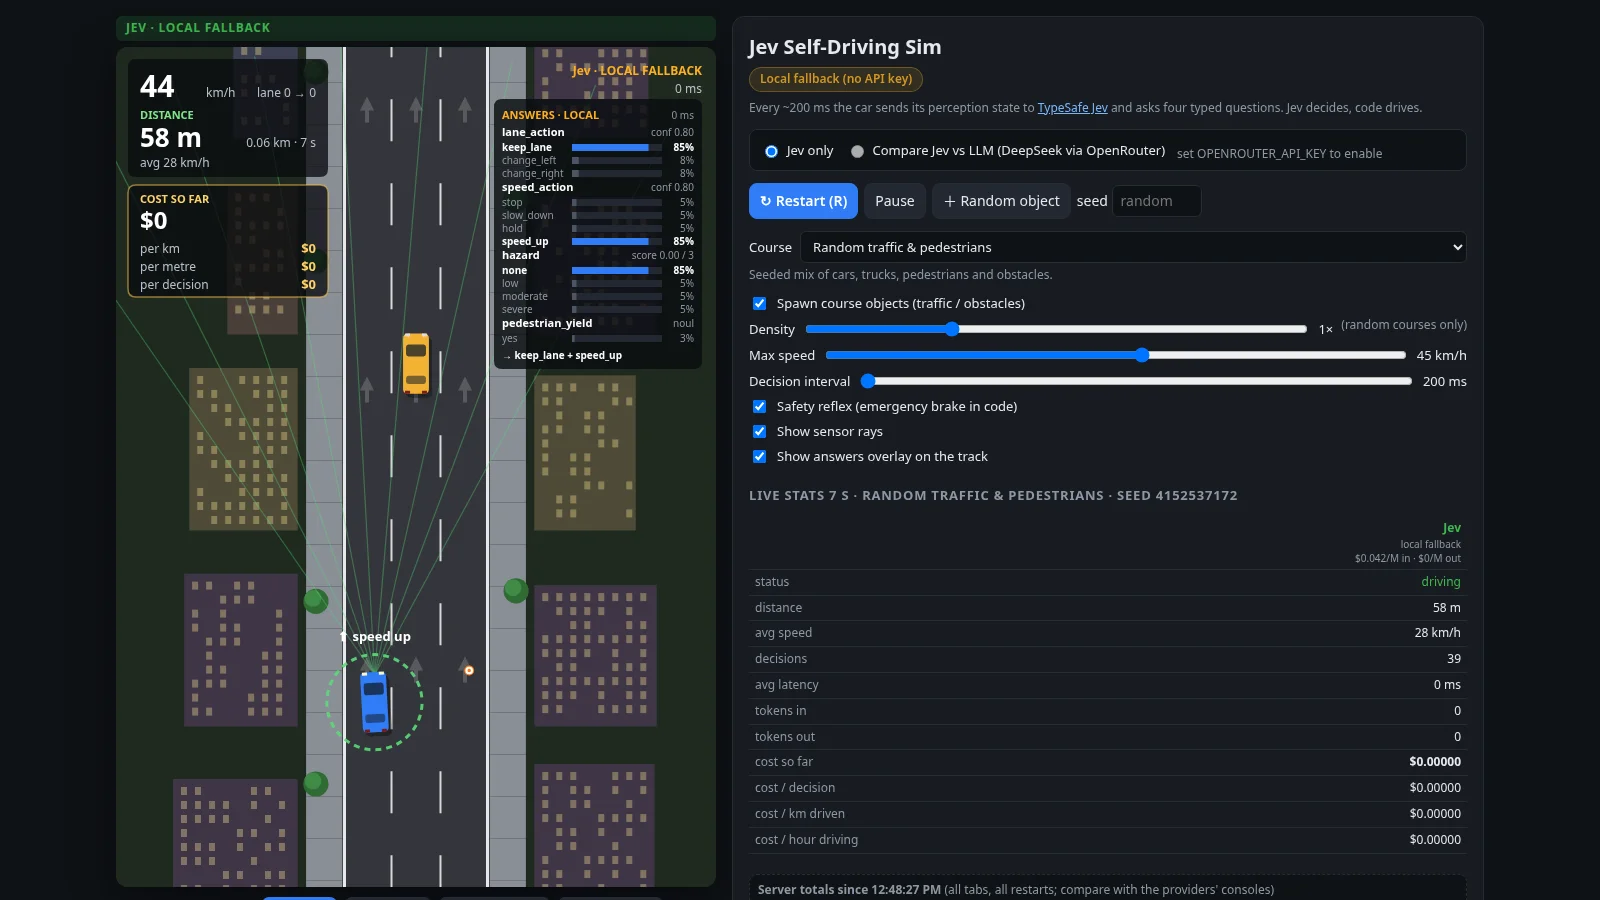
live-jev是专题里 star 最高的(20★)。
俯视角 2D 小车在浏览器里自己开,每 200 毫秒把传感器数据发给 Jev,一次问 4 个问题。最妙的是它自带的“竞技模式”:同一条赛道,左边 Jev 开、右边大模型开,实时对比距离、延迟、token 花费。
把“决策模型 vs 生成模型”的差异做成了一场看得见的比赛。这就是天生的短视频题材。
数据诚实担当:把局限写进 README 的人
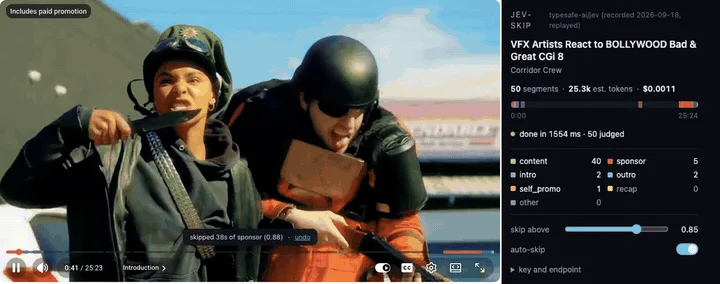
jev-skip是个 YouTube 插件:读字幕,让 Jev 给每 30 秒片段打“赞助概率”,在进度条上画热力图并自动跳过——不用等网友提交时间戳。
作者用 23 个视频实测:覆盖了 SponsorBlock 众包标注 77% 的赞助时长,每视频成本 $0.0008。README 把“只读字幕、没字幕就罢工”写得非常诚实。
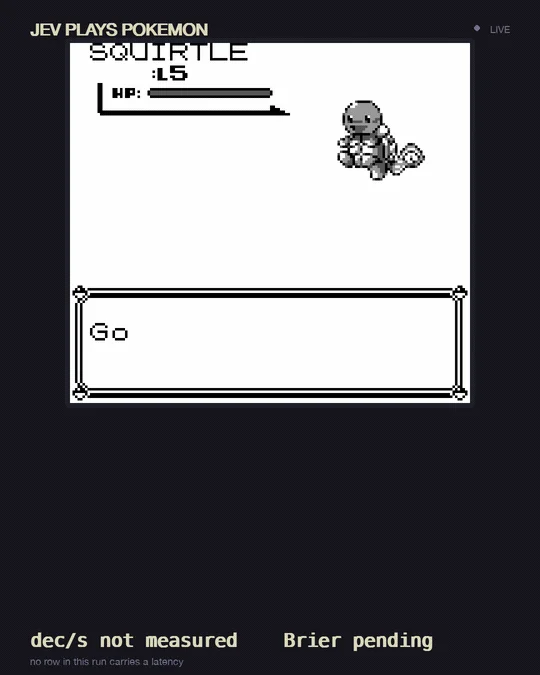
jev-plays-pokemon-red让只会输出概率的模型玩宝可梦红:约 100 毫秒做一个决定,头顶飘着实时概率条。
开场白即名场面:“Claude 玩宝可梦要思考三十秒,这个一百毫秒做一个决定。”实测约 1.3 决策/秒、每小时 $0.14。
作者还写了句让我很喜欢的话:“样本太少就不公布校准分”。在 AI 圈,诚实是稀缺品。
冷门但有趣:普通人也能会心一笑的四个
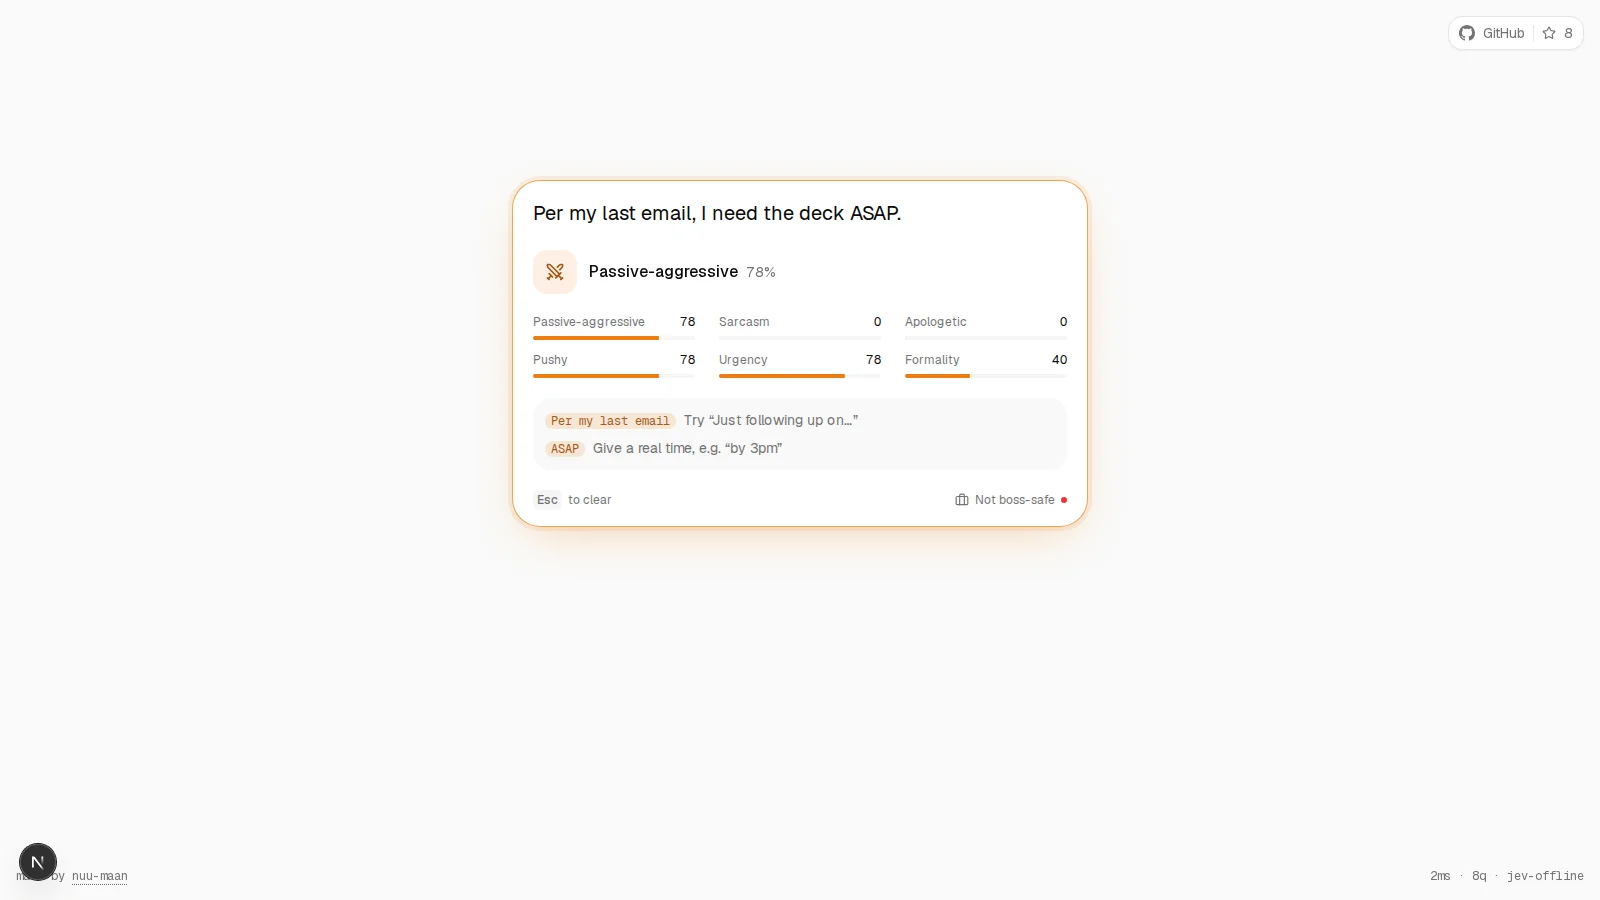
undertone:一个文本框,你打字时它实时解读语气。
README 里的例子很出圈:“Per my last email, I need the deck ASAP.” → 被动攻击·发给老板不行。每个打工人都懂的痛,AI 终于学会了抢答。
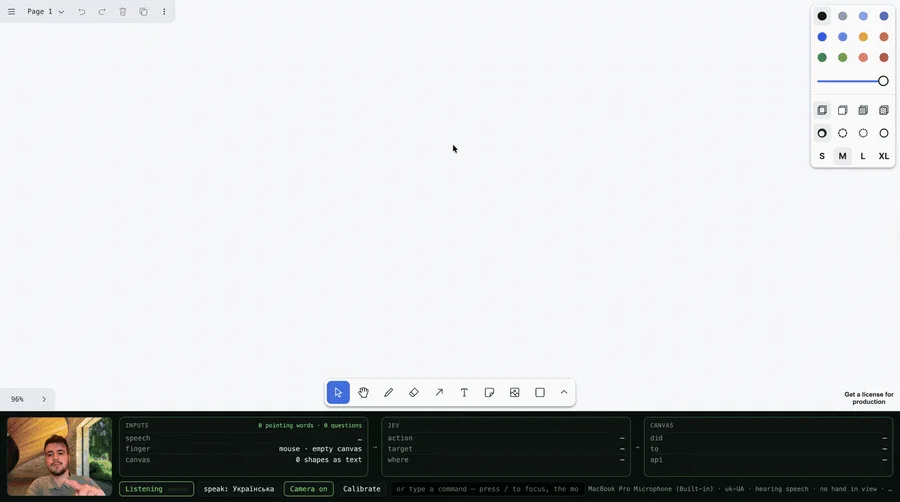
jev-canvas:对着 tldraw 画布说“make a yellow circle here”,手指往屏幕上一指,圆圈就出现在指尖下。
README 记录了两个真实踩坑:短促的乌克兰语指令最初被判成“背景杂音”,加一句说明后识别率从 12% 提到 87%。这种实战调参记录,比 demo 本身更珍贵。
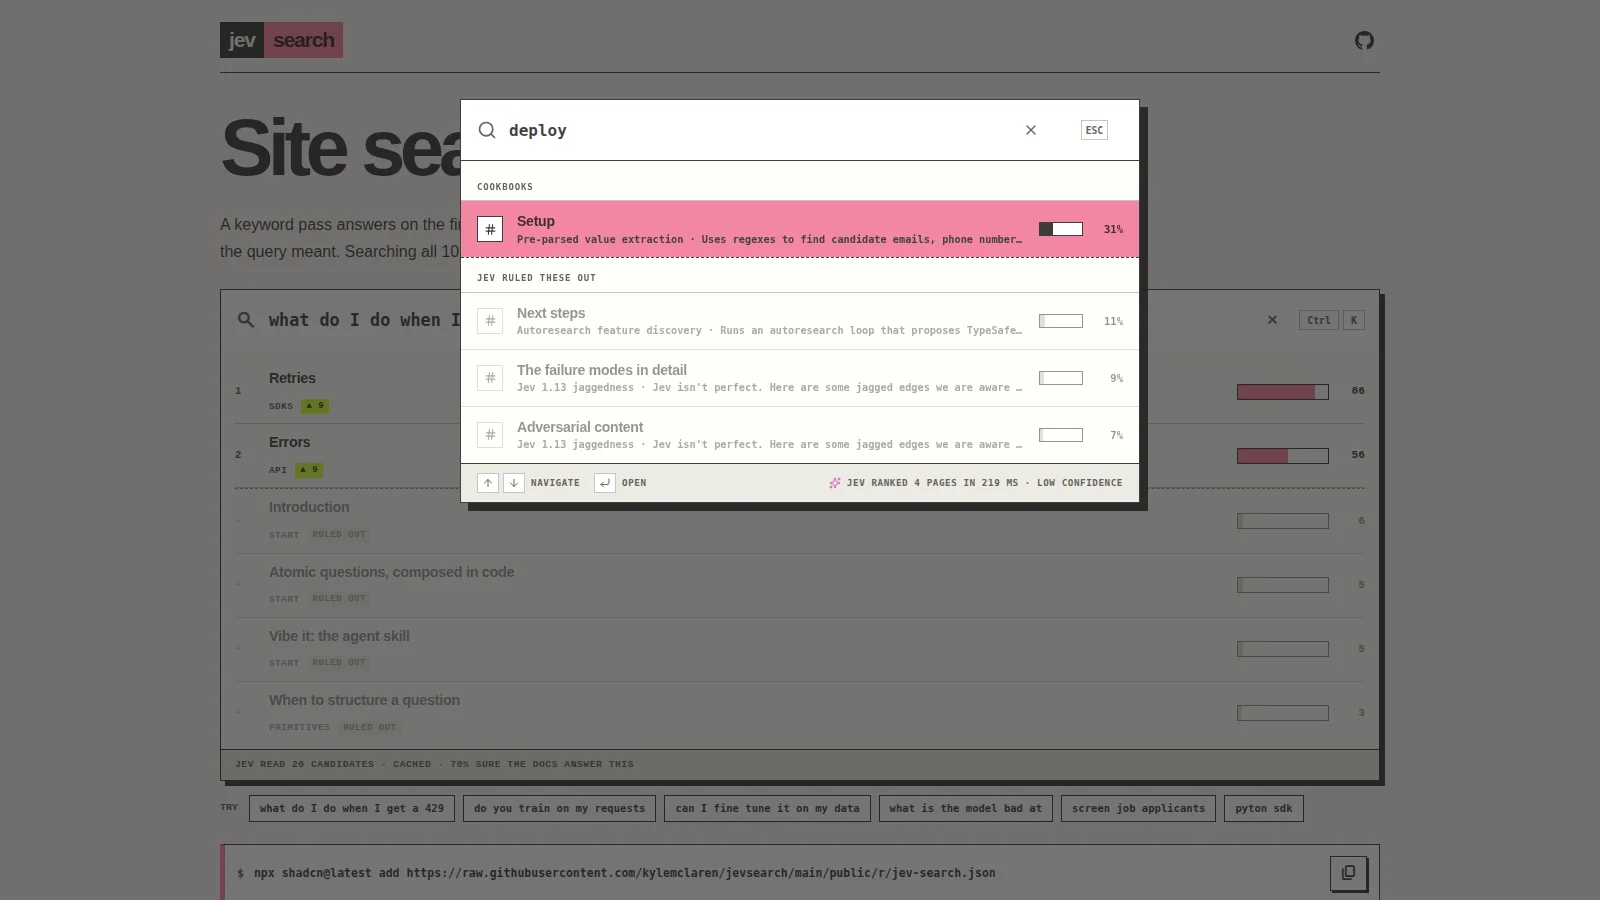
jevsearch:站内搜索组件,关键词结果先出来,几百毫秒后 Jev 按“你真正想问的”重排。
作者做了硬核基准:Hit@1 从 41% 提到 83%,把 7 个关键词库全比了下去。还诚实标注:“Jev 只负责判断不负责召回,进不了候选池的页面神仙也救不了”。
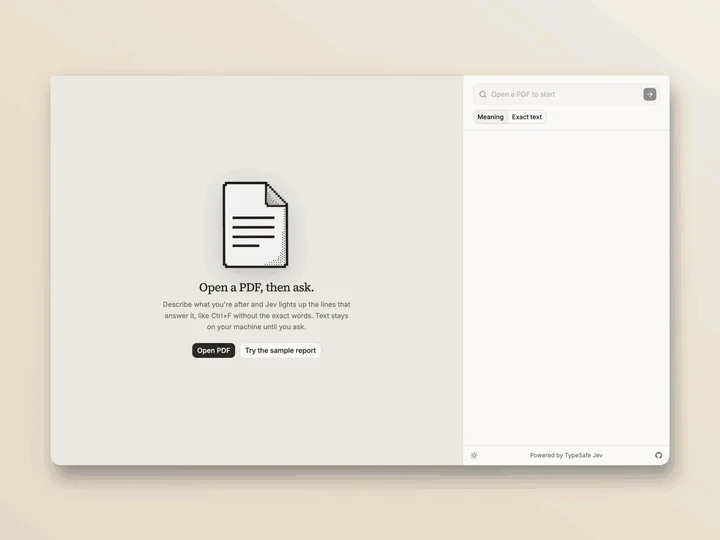
前者让你用自己的话问 PDF,命中的行自动亮起,查 15 页论文的每一行成本不到 1 美分——“不用建向量索引、不用切块”,这是 Jev 式搜索最动人的卖点。
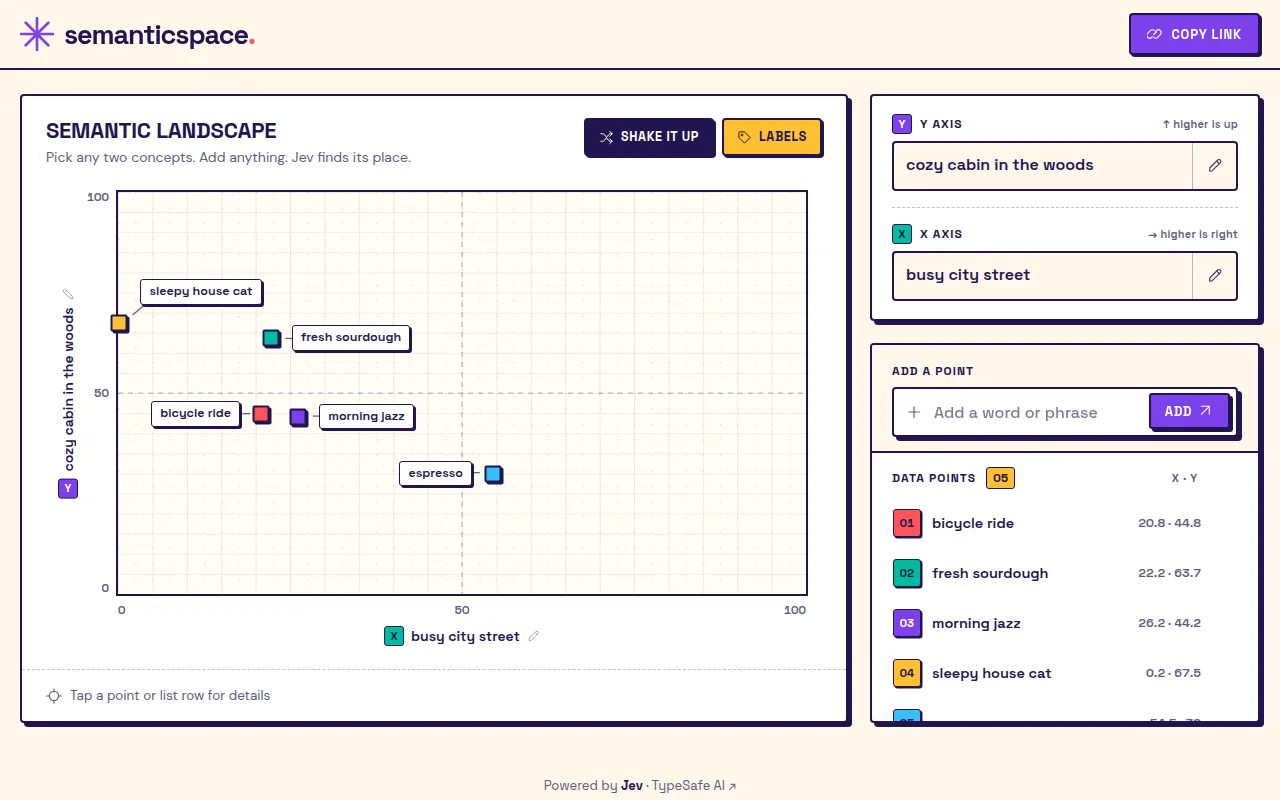
后者把词按 Jev 打的相关度分数摆进二维坐标,语义的远近变成地图上的远近,把枯燥的打分变成了可以把玩的星图。
必须说清楚的一条线
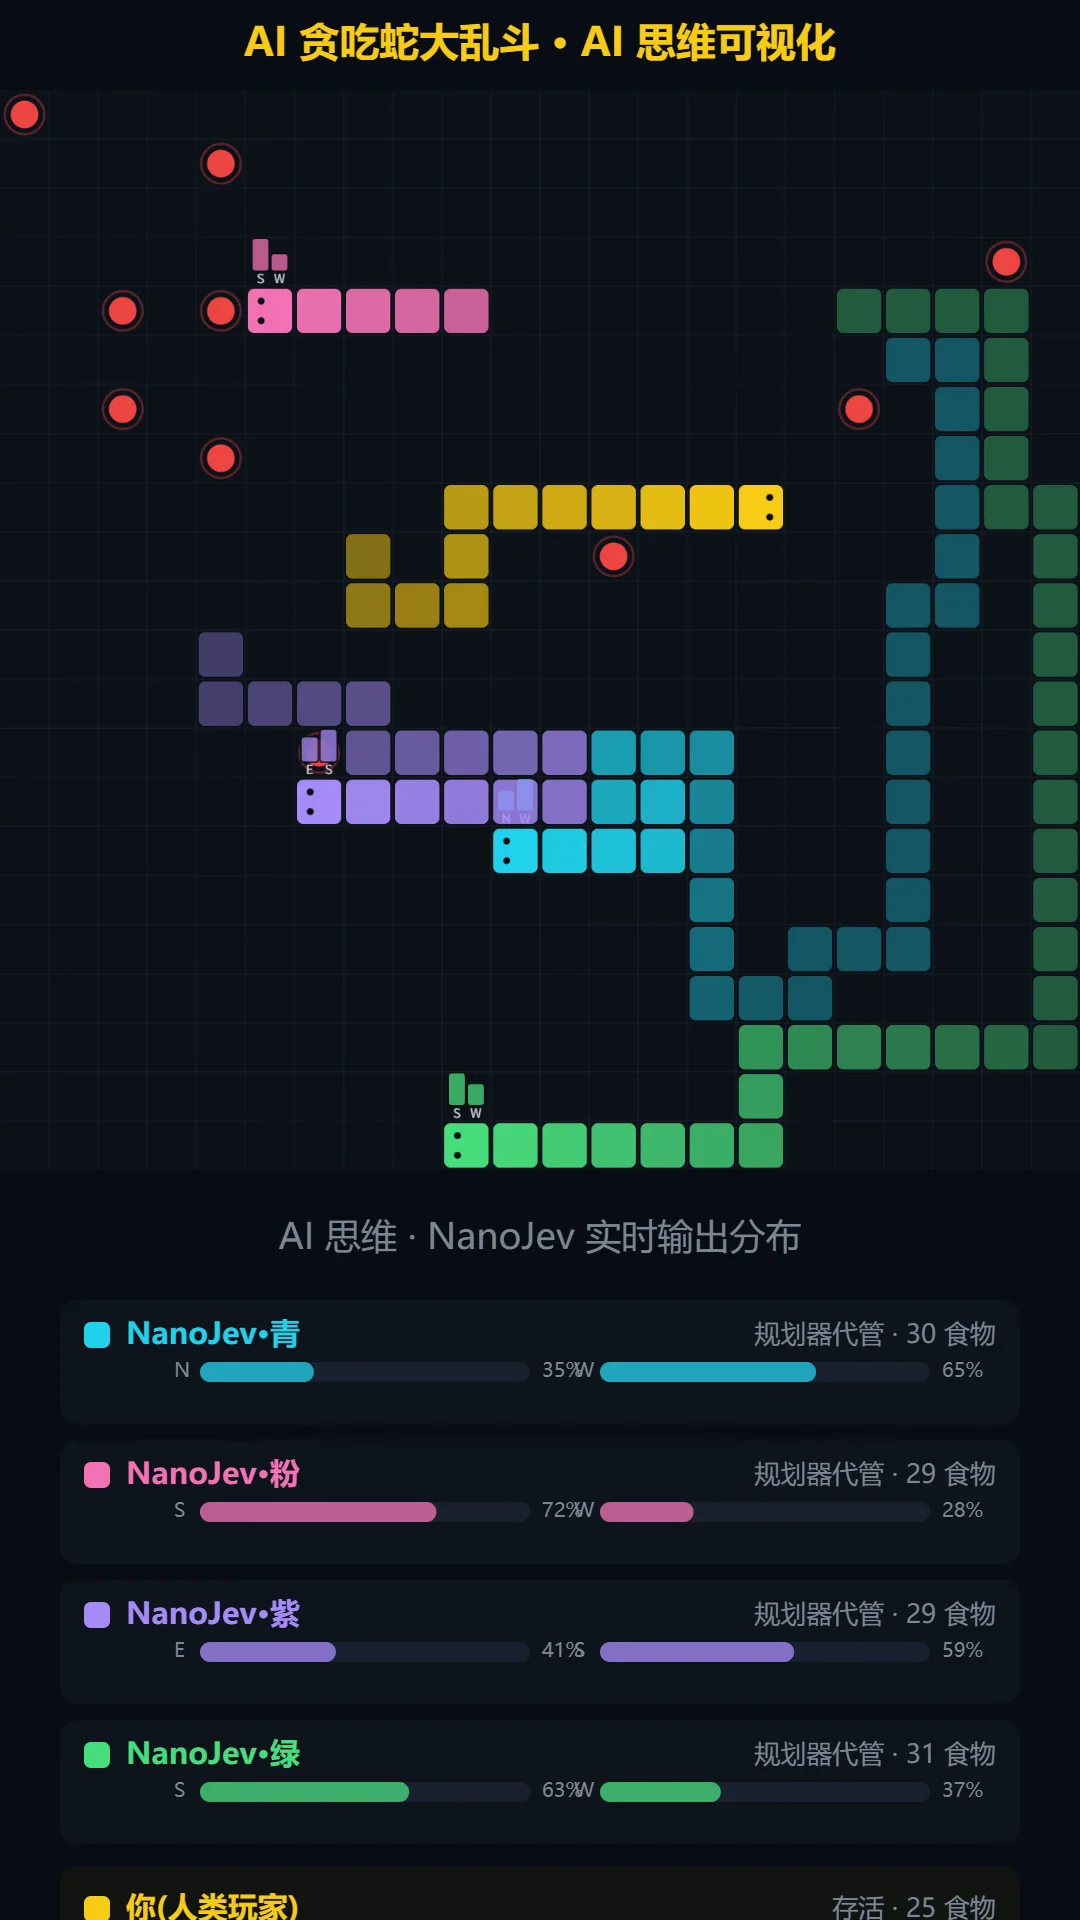
NanoJev Arena:1v4 贪吃蛇大乱斗,每条 AI 蛇头顶悬浮着实时概率条——那就是它“此刻在想什么”。README 全中文,国人开发者友好。
但必须如实说明:它用的是 NanoJev——Jev 架构的 0.6B 开源复刻,本地运行,不是 TypeSafe 官方 Jev API。因为官方架构、参数、权重都没公开,社区才出现了复刻潮。这条线我写清楚,是对你负责。
写在最后
Jev 这波给我最大的感触是:过去一年大家都在卷“生成”,但软件真正缺的可能是“判断”。
生成是给人看的,判断是给机器用的。当判断便宜到可以塞进每一次循环,软件的写法会变:搜索先重排、动作先审批、内容先分流——“先审判一次”会成为默认动作。杰文斯悖论会应验:判断越便宜,用得越多。
对独立开发者来说,机会也很具体:别只想着用 AI 生成内容,想想你的产品里有哪些“判断”现在是靠规则硬写的、靠人工盯的——那些地方,都值得接一个“聪明的 if 语句”。
「好想法,值得被看见。」——这 10 个里,你最想先点开哪个?评论区聊聊:你的产品里,有没有一个“本该被审判一次”的环节?